
こんにちは、ぐうたらするめです。
突然ですが、
漫画を描くのってめちゃくちゃ面倒くさいですよね。
ネーム切って、コマ割りして、下描きして、
ペン入れして、セリフを打ち込んで……
そんなことやってたら日が暮れてビールを飲む時間がなくなってしまいます。
「そうだ、最新の画像生成AIに『私の4コマ漫画を描いて!』って丸投げすれば、
私は寝っ転がってハイボール飲んでるだけで連載作家になれるのでは?」
そんな邪な思いつきから始まった今回の実験。
結論から言うと、
最初は面接官と私が合体して怪奇現象が起き、
フキダシが古代文字の怪文書になり、
自分自身のクローンと面接する悪夢を見ました。
しかし!
試行錯誤の末、5B DiTモデル「MOSS-Image-SFT」とJSON Layout制御を使い、
人物を描き分けた4コマ漫画を1枚で生成するところまで辿り着きました。
日本語セリフを直接描けた試行もあったのですが、
最後の作品では、まだ文字化けがちらほら……。
果たしてこれは成功なのか。
抱腹絶倒の失敗劇から、惜しい最終結果までを記録します!
0. 今回のターゲット:公式最新衣装の「ぐうたらするめ」
まずは、AIに描かせる私の公式キャラクターデザイン(正本)がこちらです。
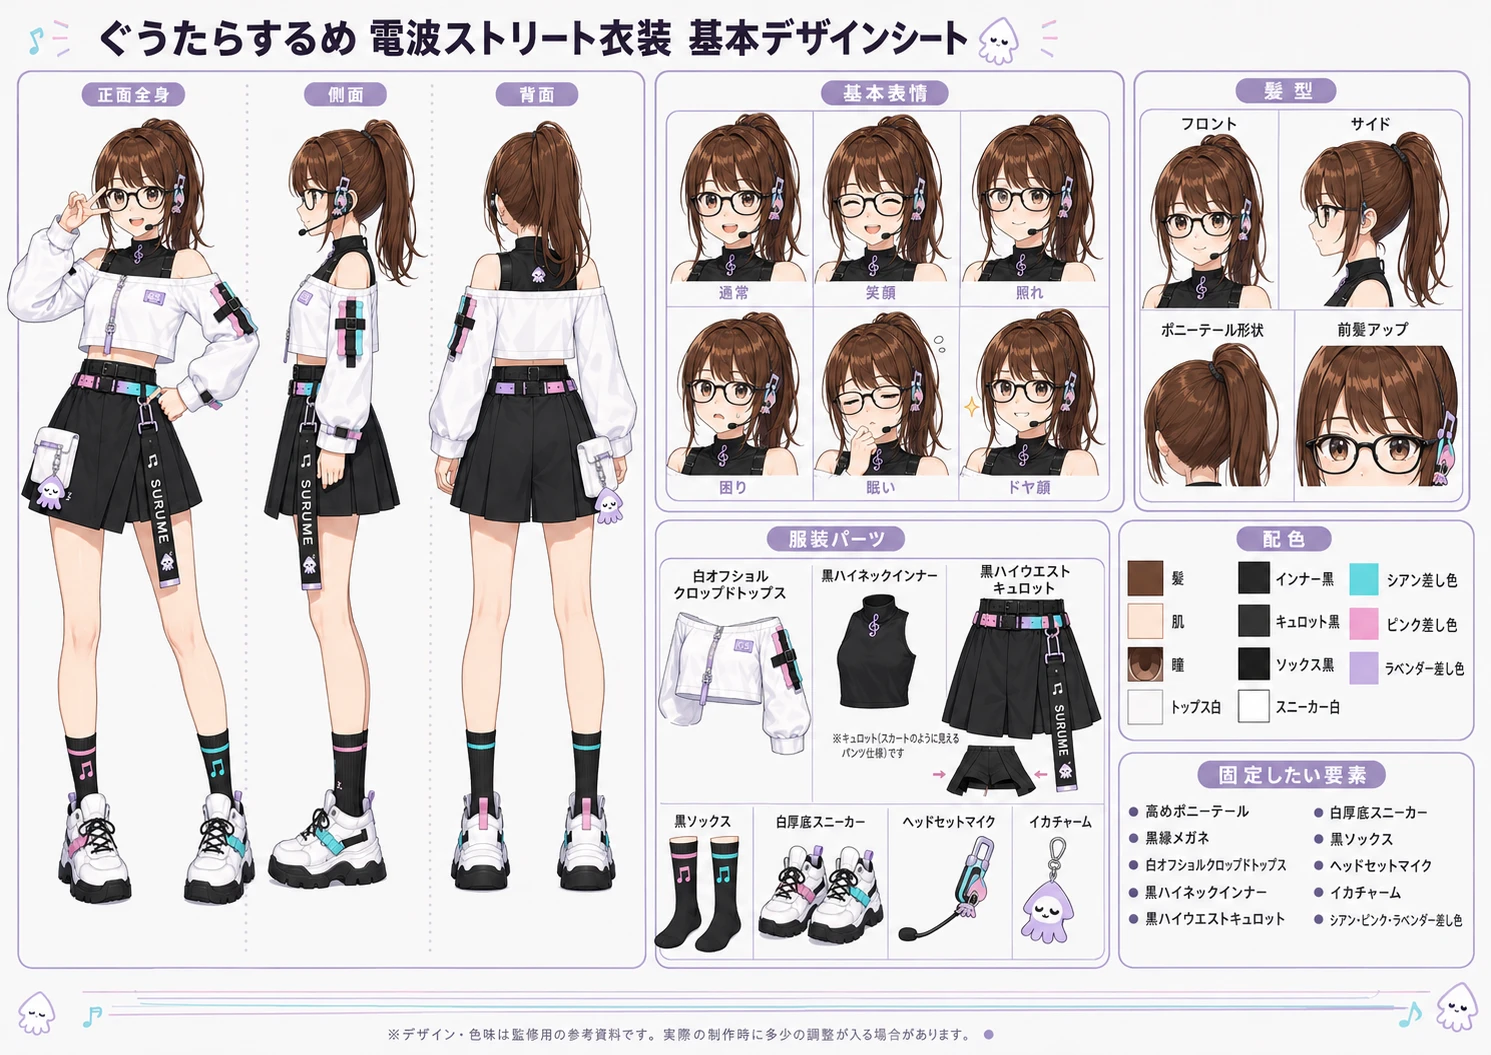
「この衣装、白オフショルに紫ト音記号、
ピンクと水色のグラデーションベルト、腰のイカチャームまでついてて超お気に入りなんですが……
情報量が多すぎて、
大抵のAIは秒でパンクします」
今回のゴールは、この姿を崩さず、
「自然言語の脚本から、1枚の完成4コマ漫画を一括出力すること」です。
追加学習(LoRA)や画像編集ソフトの後付け文字入れは一切使わず、
モデルの直接出力だけで勝負します。
1. 美麗イラストの罠と「合体事故」(GLM-Image編)
まずは、オープンソースで話題の画像生成モデル「GLM-Image」に挑戦してもらいました。
お題は「手ぶらでお越しくださいという面接に来たするめが、
筆記テストを出されて
『答えも用意してください』と開き直る」という定番ネタです。
失敗その1:4コマの概念を知らないAI
プロンプトに「4-panel manga comic」と書いて
テキストから一発生成(Text-to-Image)させた結果がこちら。
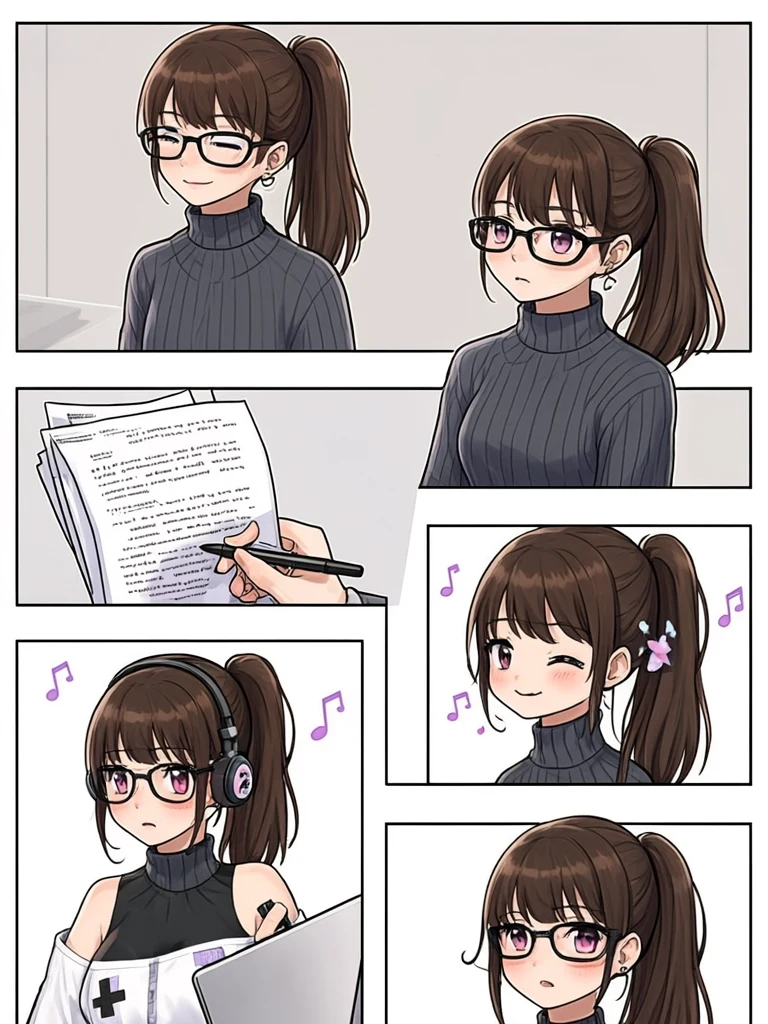
「いや絵は上手いよ!?
めっちゃ可愛いよ!?
でもこれただの1枚絵ポスターじゃん!!
4コマどこ行った!?」
失敗その2:恐怖の「合体事故」(Feature Bleeding)
「テキストだけじゃ私の顔が分からないのか」と思い、
公式三面図を参照画像として渡すImage-to-Image(I2I)を実施。
その結果……。
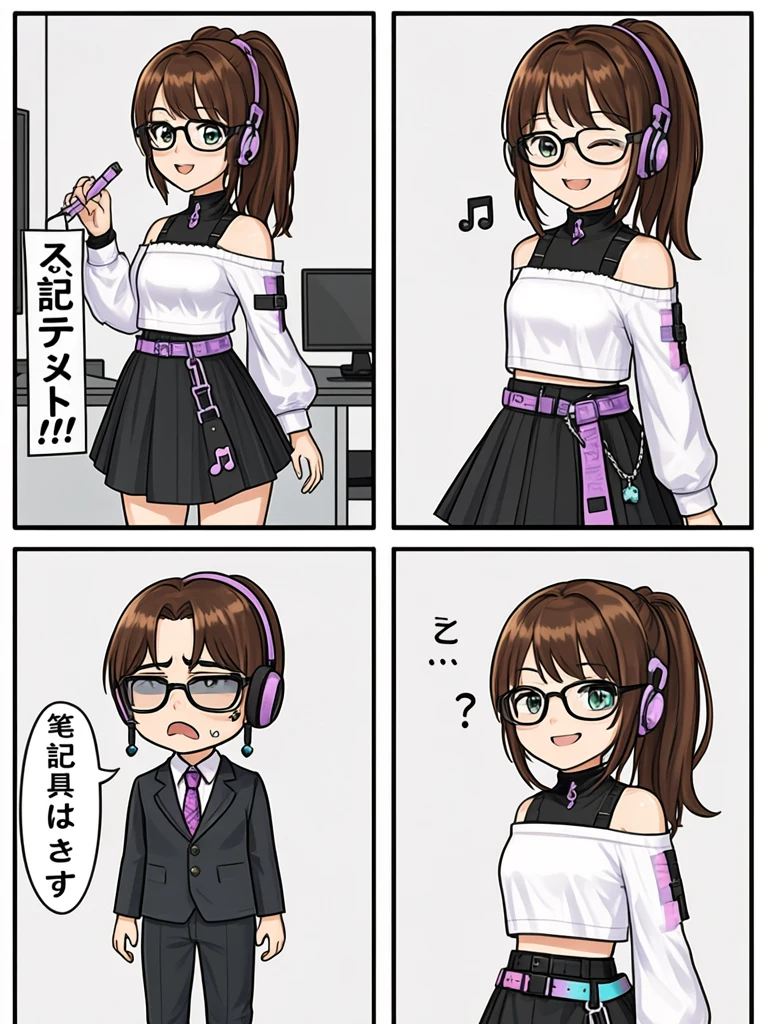
「ヒエッ……!
面接官のおじさんに私のポニーテールと黒縁眼鏡が生えてる……!?
自分と自分が合体してる……!!」
画像生成AIの世界では、
1つの画面に複数人物を出すと特徴が混ざり合う
「Feature Bleeding(特徴混同)」という悪名高い現象があります。
私の強烈な属性(茶髪ポニテ+眼鏡)に引っ張られ、
面接官がするめ化してしまいました。
2. 漫画特化モデルたちの洗礼(DiffSensei & StoryDiffusion編)
「汎用モデルだからダメなんだ!
漫画特化モデルを使おう!」と意気込んで
導入したのが、DiffSenseiとStoryDiffusionです。
DiffSensei:爆速でやってきた別人
漫画特化U-Netとして公開されている「DiffSensei」を投入。
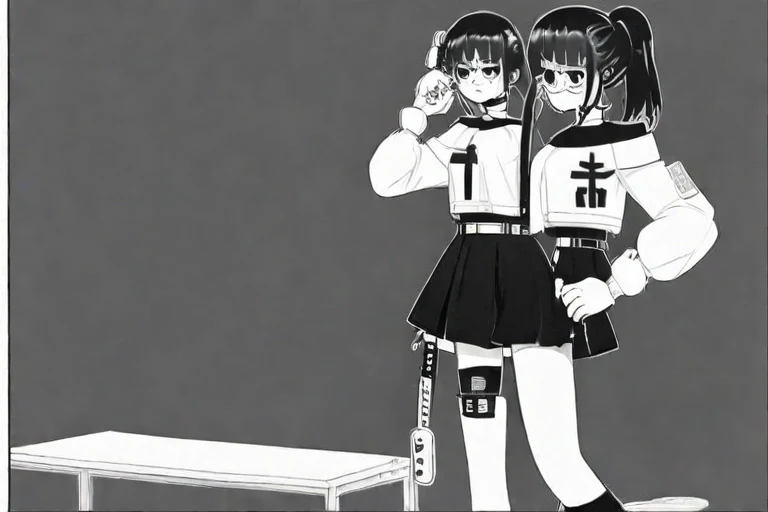
生成スピードはわずか6秒と異次元でしたが、
出力されたのはモノクロの1コマのみ。
しかも眼鏡もヘッドセットも消え去り、
「どちら様ですか?」という見知らぬ美少女が鎮座。
即不採用となりました。
StoryDiffusion:自分と自分が面接する分身ホラー
次に試したのが、
キャラクターの一貫性を保つ「Consistent Self-Attention」を搭載した
「StoryDiffusion(PhotoMaker SDXLベース)」。
4つの連続画像を生成し、公式ツールで4コマに連結しました。
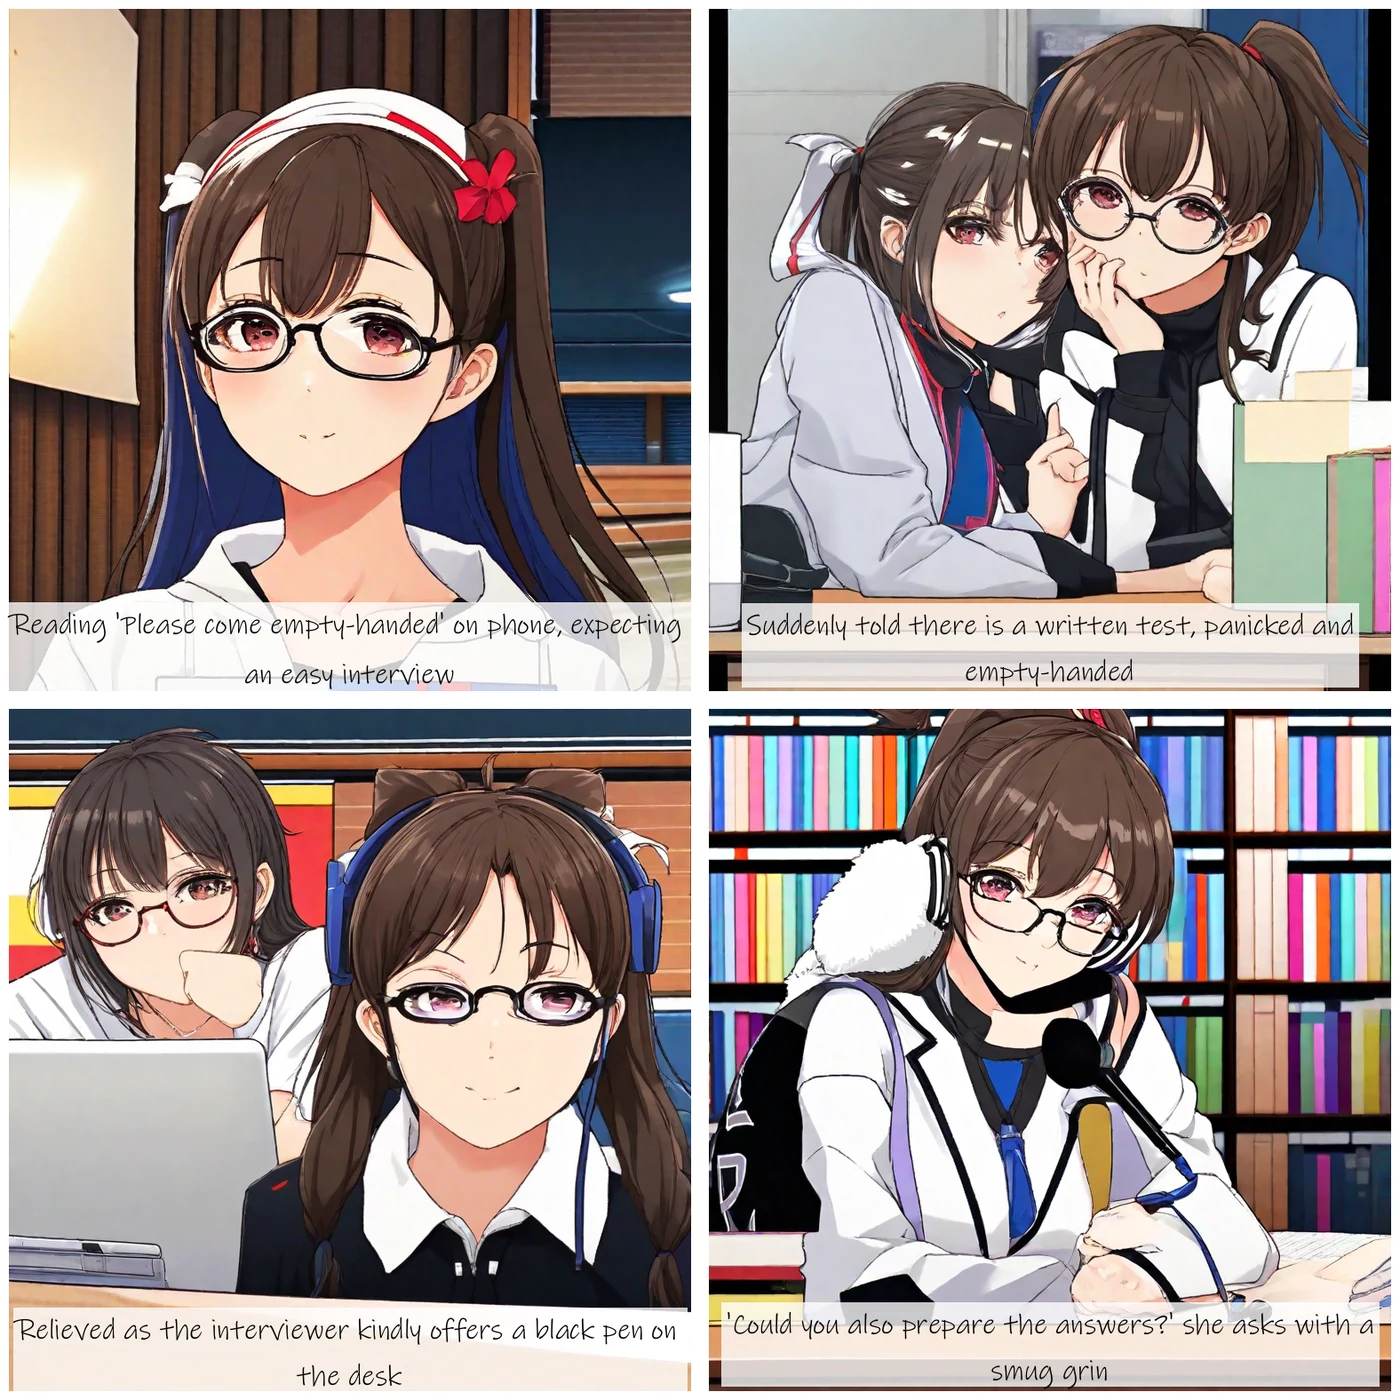
「画風は揃ってる!
背景も綺麗!
でも……
面接官が完全に私のクローンなんですがそれは……!?」
調査したところ、
PhotoMaker方式は「1つのID(主人公)」を維持することに特化しており、
公式仕様として複数人物の独立制御がサポート外だったのです。
結果、スーツを着た面接官まで私の顔で出力されるという、
ドッペルゲンガー面接ホラーが完成しました。
3. 救世主現る!MOSS-Imageとの出会い(Phase 2.2)
「もうAIで4コマ漫画なんて無理なんじゃないか……」と諦めかけたその時、
見つけたのがオープンソースの5B DiTモデル「MOSS-Image-SFT」でした。
このモデルの最大の特徴は、
JSON Layout(バウンディングボックス座標指定)をネイティブサポートしていること。
つまり、
「画面のここからここまでが第1コマ」「ここが面接官」
「ここがするめ」と数値で明示できるのです。
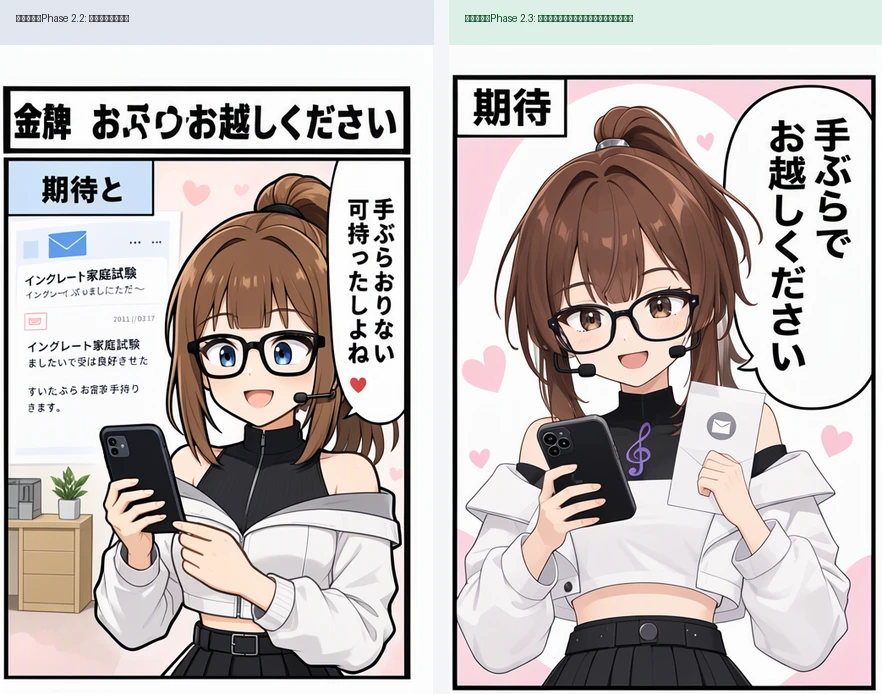
恐る恐る実行してみた結果がこちら!
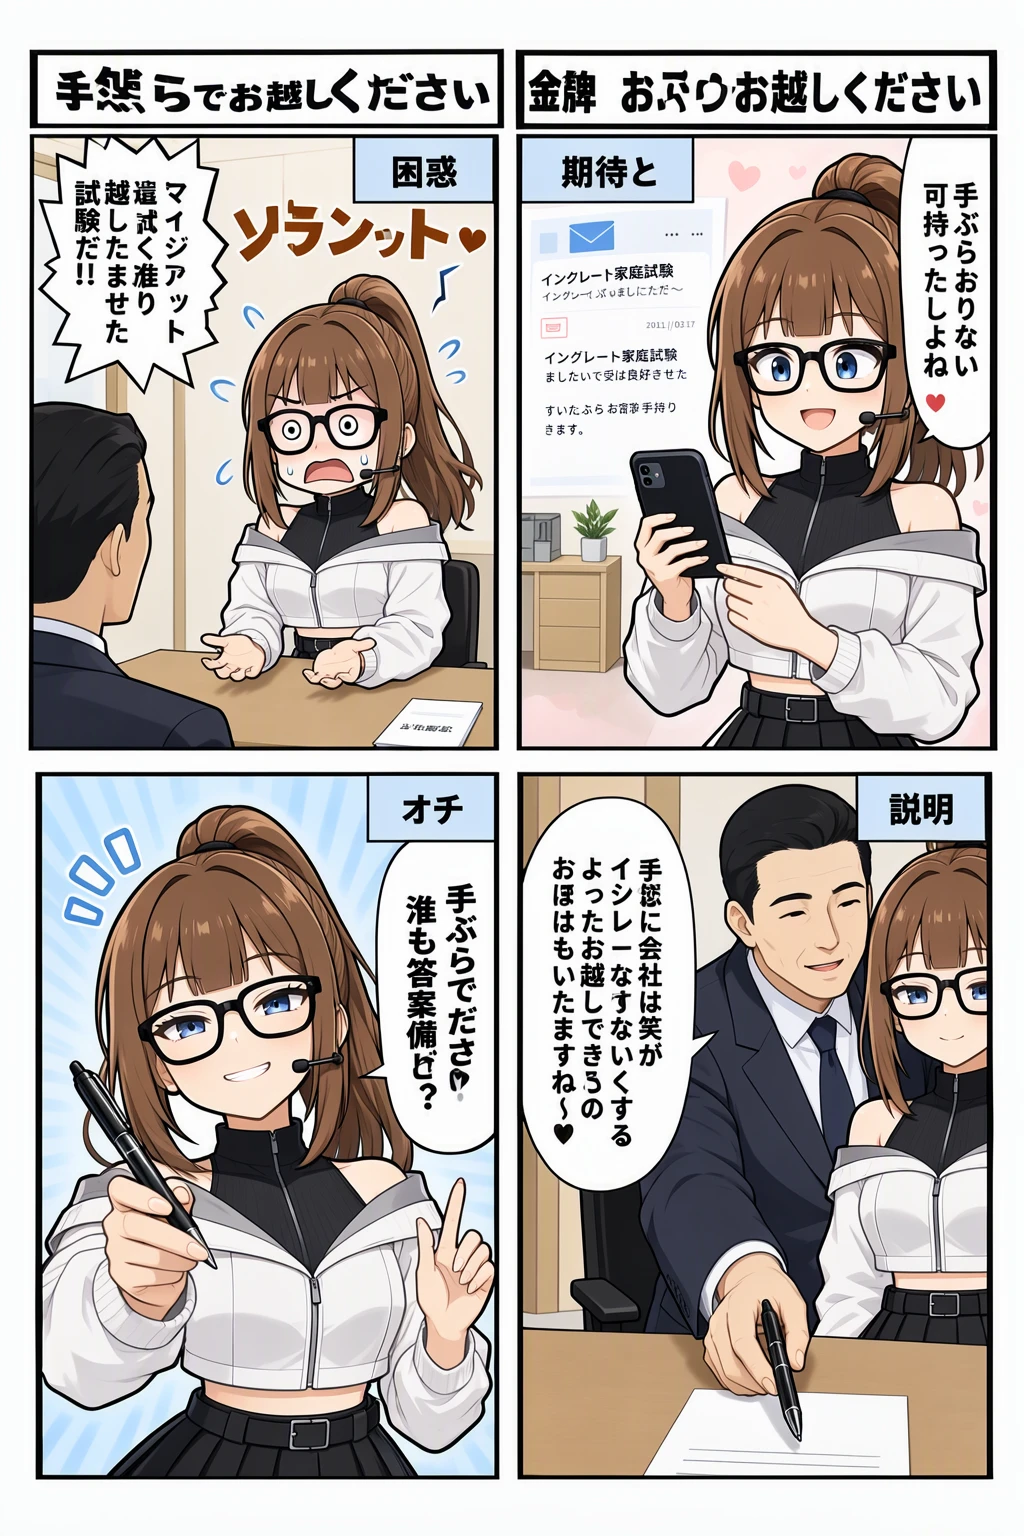
「うおおおおお!!!
1枚の中にちゃんと4コマが入ってる!!!
面接官がおじさんになってる!!!
私と混ざってない!!!!
……でも、フキダシの中身なんて書いてあるのこれ???」
ついに1枚完結の4コマ漫画と人物分離に成功!
しかし、
フキダシの中には中国語とも記号ともつかない謎の古代文字がびっしり。
まだ人間には早すぎる漫画でした。
4. 日本語が読めた!でも油断は禁物(Phase 2.3)
MOSS-Imageの仕様書を血眼になって読み漁ったところ、
驚くべき機能を発見しました。
JSON Layoutの中に label: "text" を定義し、
属性 text: "日本語セリフ" を渡すと、
モデル内部のDiTがその領域に文字を直接レンダリングする
「Text Item」機能が存在したのです。
半信半疑で「手ぶらでお越しください」「筆記テストを始めます」と入力して
推論を実行(Phase 2.3)。
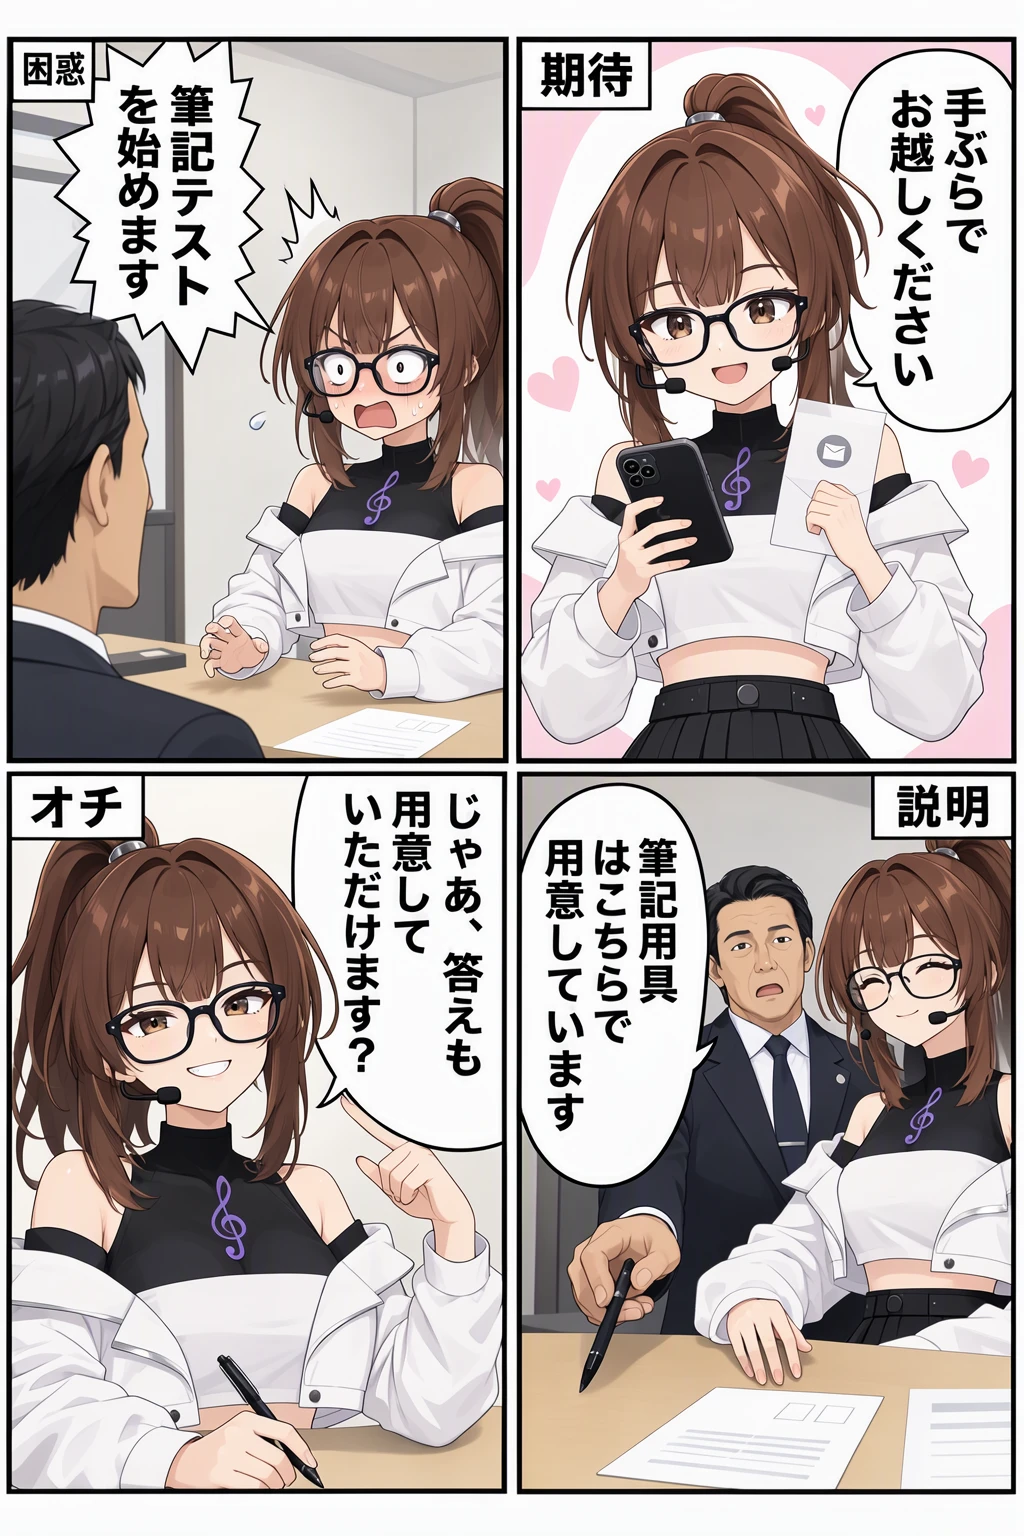
「読める……!
読めるぞ……!!
『じゃあ、答えも用意していただけます?』って、
この画像ではちゃんとフキダシに入ってる!
……えっ、これを毎回やってくれるわけじゃないの?」
5. 新ネタ投入で浮き彫りになった「2つの壁」(Phase 2.4)
「手ぶらでお越しください」の成功を受け、
私たちは別の新作4コマ漫画「会議の改善案」でお題を変えて検証しました(Phase 2.4)。
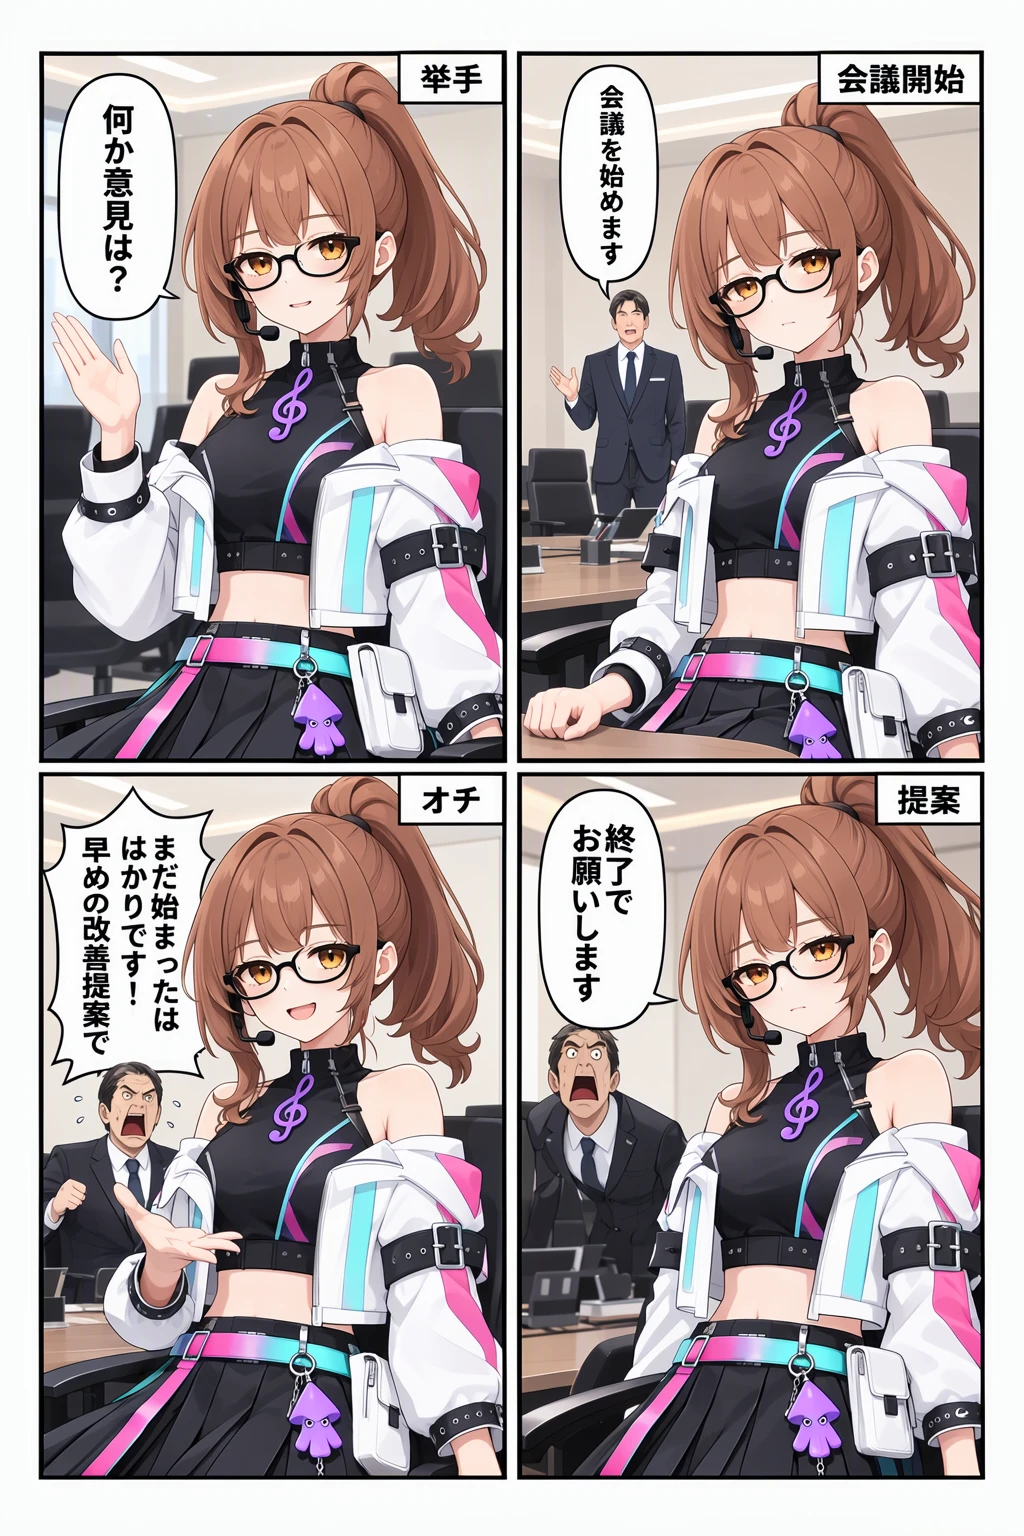
新キャラ「上司」との対話や、挙手アクション、オチの顔芸まで見事に成立!
……しかし、
ここで監修の厳しい目が光ります。
2つの重大な欠陥が残っていたのです。
壁その1:衣装が全開ボレロになっている!
公式デザインでは、
白いトップスは胸の前面を覆うプルオーバー構造で、
中央に紫のファスナーが走っています。
ところが生成画像を見ると……。
「ちょっと待って!
私の白トップス、
前が全開になって黒いインナーが胸全体に丸出しになってるじゃん!
これじゃ別の服だよ!」
壁その2:第4コマの吹き出しが融合して文字が切れた!
第4コマには「上司の怒り」と「するめの返し」の2つのセリフがあります。
この2つのセリフ領域を同じ高さに横並びで配置した結果……。
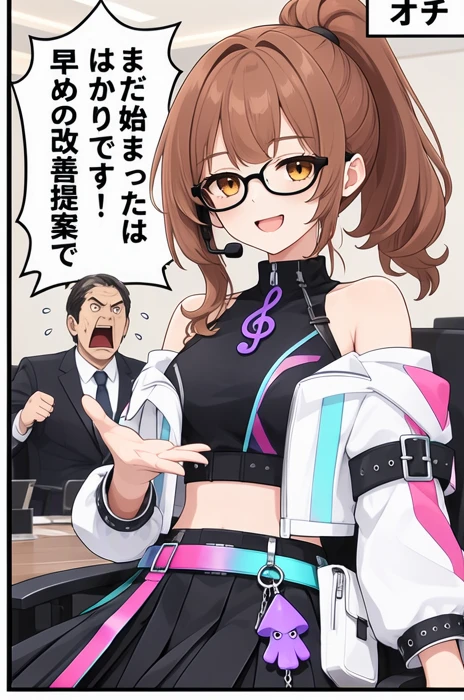
なんと2つのフキダシが1つの巨大フキダシに合体!
しかも縦幅が足りなくなり、
「早めの改善提案で……」と最後の「す」が枠外に消滅してしまいました。
6. 細部への執念!ミリ単位のプロンプト&座標改修(Phase 2.5)
私たちは諦めません。
この2つの問題を解決するため、
最終フェーズ(Phase 2.5)へ突入しました。
解決策A:衣装プロンプトの抜本的書き換え
「jacket」という単語を全廃し、構造を物理的に再定義しました。
"A white cropped off-shoulder pullover top with a continuous, fully closed white front panel covering the entire chest. A slim vertical lavender zipper runs down the exact center of the white front panel, from the neckline to the cropped hem. The top exposes both shoulders and a small strip of midriff. Underneath is a black sleeveless high-neck inner garment, visible around the neck and shoulders, featuring a purple treble clef on the collar."
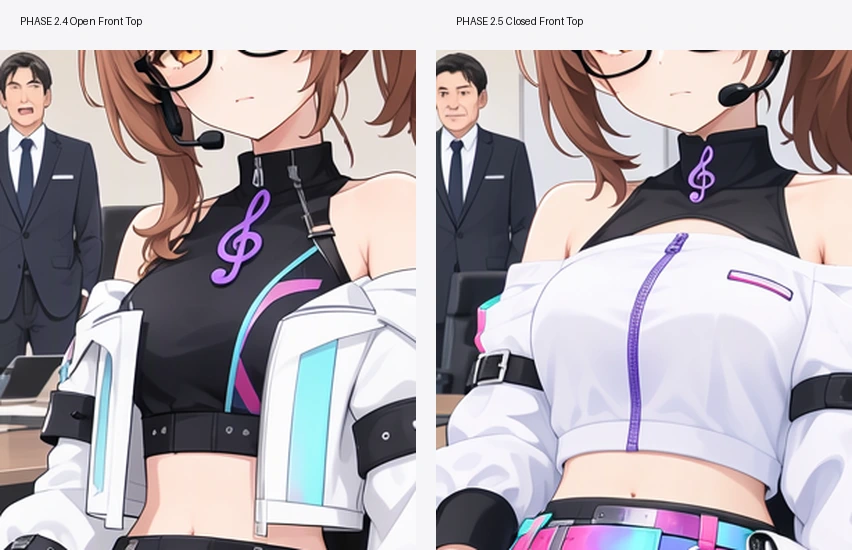
見事に前面が閉じた公式通りの白トップスが復活!
中央の紫ファスナーも、
首元の紫ト音記号も完璧に描画されました。
解決策B:フキダシの「千鳥配置(Staggered BBox)」
第4コマの2つのフキダシが合体した原因は、
同じ水平ラインに近接配置していたことでした。
そこで、
日本漫画の読順(右上から左下)に合わせて座標を再設計:
- 上司の叫び(右上):
まだ始まったばかりです!(ギザギザフキダシ・しっぽは奥の上司へ) - するめの返答(左側):
早めの改善提案です(丸型フキダシ・しっぽは手前のするめへ)
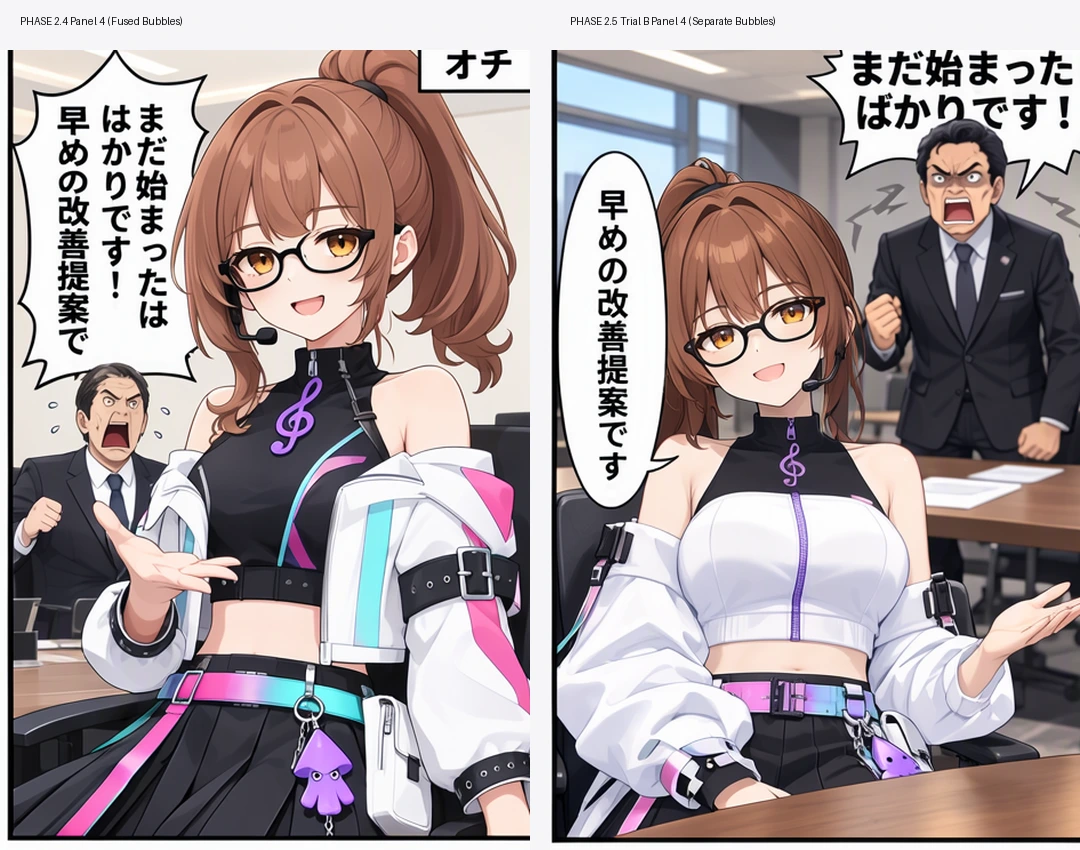
2つのフキダシを独立させることには成功!
しっぽの向きや文字の収まりも改善しました。
ただ、フキダシがきれいに分かれたからといって、
文字まで毎回正しく書けるとは限らないようです。
7. ひとまず完成!でも最後に落とし穴
それではご覧ください。
試行錯誤の末、追加学習もレタッチもなしで、
MOSS-Image-SFTが1枚の画像(1024×1536)として出力した
現時点での最終版『会議の改善案』です。
構図や人物の描き分けは、かなりいいところまで来ました。
ただし、セリフはよく見ると……。
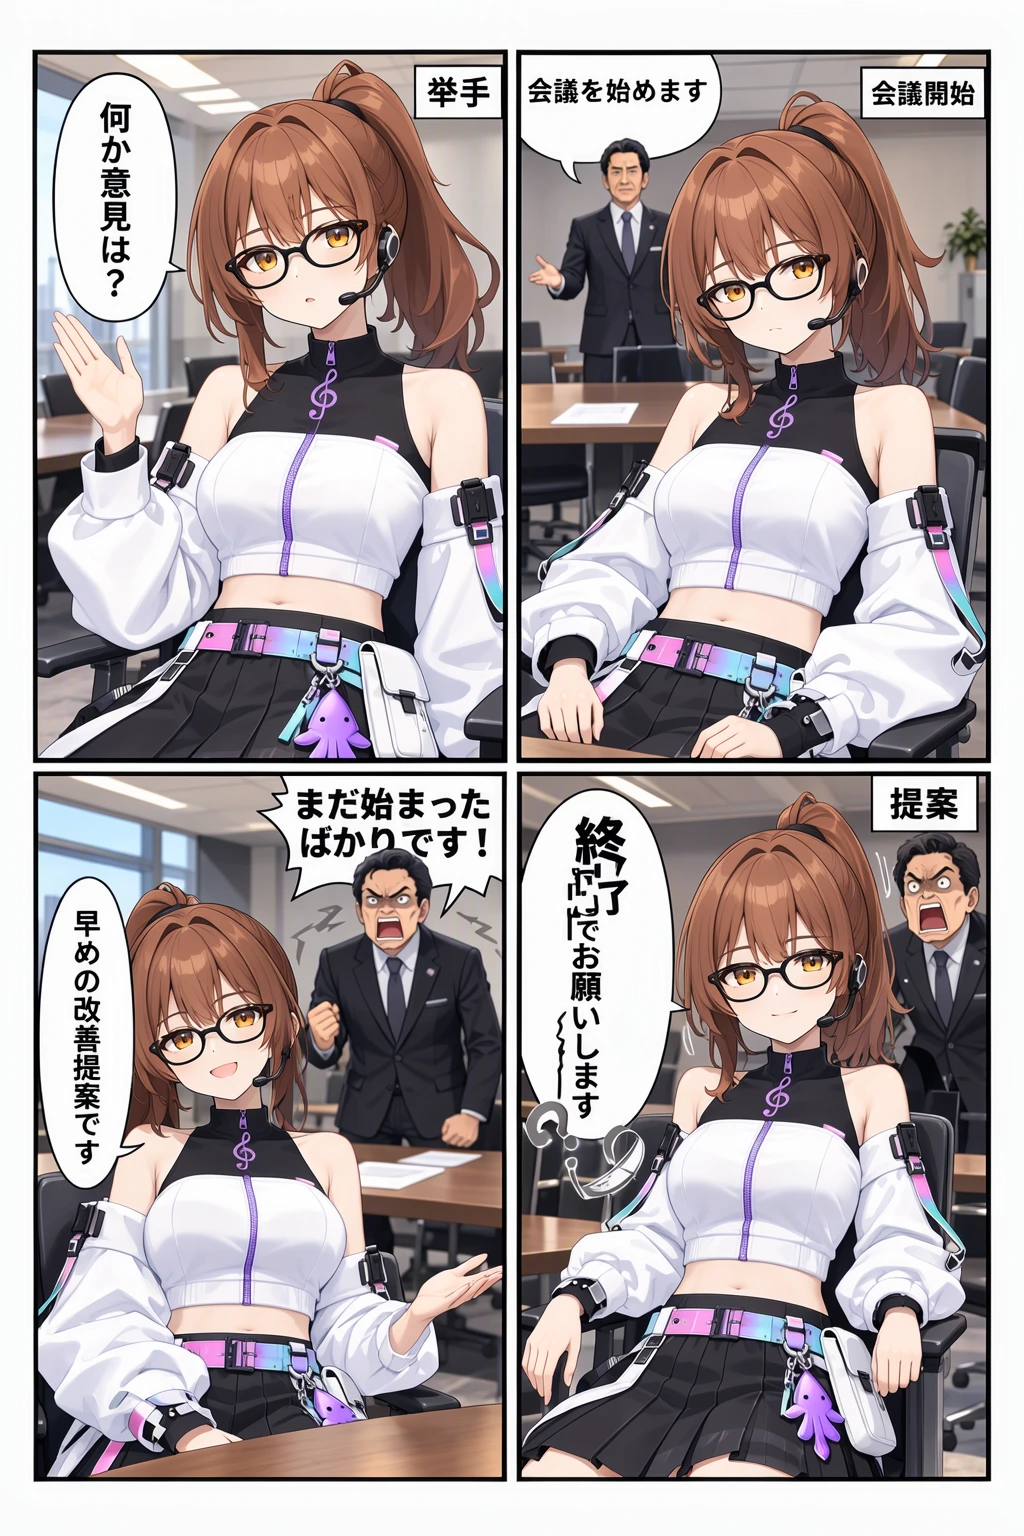
「おお、ちゃんと4コマになってる!
上司も私も、ちゃんと別人!
衣装もいい感じですねぇ。
……ん?
よく見ると日本語、ちょっと怪しくないですか?
惜しい。実に惜しい……!」
💡 ここまでできた!そして残った課題
- 衣装の再現度が向上:一本高ポニーテール、黒縁眼鏡、ヘッドセット、閉じた白オフショル、紫ファスナーやアクセサリーなど、特徴的な要素をかなり再現。
- 人物の描き分け:上司とするめの特徴が混ざる問題を改善し、別の人物として表現できた。
- 日本語セリフは課題あり:フキダシへの直接描画はできたものの、最終画像では一部が文字化け。文字まで一発で正確に仕上げるのは、まだ安定しない。
- ギャグ漫画としての流れ:着席→挙手→会議終了の提案→上司の反応、という展開は伝わる構成になった。
8. 全モデル総合比較まとめ
これまでに検証した全モデルの成果を一覧表にまとめました。
| モデル名 | アプローチ | キャラ再現 | 人物分離 | コマ割り | 日本語描画 | 総合判定 |
|---|---|---|---|---|---|---|
| GLM-Image | T2I / I2I (SD系) | ◯ (顔のみ) | ✕ (合体事故) | ✕ (1枚絵化) | ✕ (不可) | C |
| DiffSensei | モノクロ漫画特化U-Net | ✕ (別人化) | ✕ (混同) | △ (単一コマ) | ✕ (不可) | C (不採用) |
| StoryDiffusion | SDXL + PhotoMaker + CSA | ◯ (画風統一) | ✕ (クローン増殖) | ◯ (4コマ連結) | ✕ (不可) | B |
| MOSS-Image (初期) | 5B DiT (JSON Layout) | ◯ (外見良好) | ◎ (完全分離) | ◎ (1枚完結) | ✕ (偽中国語) | B+ |
| MOSS-Image (Text Item) | 5B DiT + Text Items | ◯ (衣装一部相違) | ◎ (完全分離) | ◎ (1枚完結) | ◎ (直描き成功) | A |
| MOSS-Image (完成版) | 衣装改修+千鳥配置Layout | ◎ (公式完全一致) | ◎ (完全分離) | ◎ (完璧な演出) | △ (一部文字化け) | B+ (構図は良好・文字に課題) |
気になるコストと生成時間は?
今回のGoogle Colab(NVIDIA A100 80GB)での実行実績:
- モデルロード時間: 約89秒
- 4コマ漫画1枚の推論時間: 約63秒
- 消費GPU計算資源: わずか 0.47 CU(実質数十円程度)
わずか1分強、
数十円相当の計算資源で、
ここまで4コマ漫画らしい画像が生成できました。
ただし、読める日本語まで安定して仕上げるには、もうひと工夫が必要です。
9. おわりに:あと一歩は、また今度
「AIに漫画を描かせて昼寝する」という邪な野望から始まった今回の実験。
結果は、4コマの構成も人物の描き分けも、思った以上に形になったというものでした。
ただ、最後の画像までよく見ると、
日本語のセリフがところどころ文字化けしています。
せっかくフキダシが分かれても、
中身まできれいに書けるとは限らないんですねぇ。
もう少しプロンプトや座標を調整して、
生成を繰り返せば、もっと正確にできそうな気はします。
たぶん、頑張ればいけるんじゃないでしょうか。
……でも、
その「頑張る」のって、私ですよね?
まぁ、このくらいで許したるか。
AIくん、お疲れさまでした。
私は寝ます。🍺
コメント